Significant is niet hetzelfde als belangrijk
Er staat een sterretje in de tabel. Het verschil met vorige meting is significant, p < 0,05. In de vergadering wordt geconcludeerd dat de campagne heeft gewerkt.
Misschien is dat waar. Maar het sterretje zegt het niet.
Wat significantie werkelijk betekent
Een significantietoets beantwoordt één vraag: hoe waarschijnlijk is het dat ik dit verschil in mijn steekproef zou zien als er in werkelijkheid geen verschil bestond? Bij p < 0,05 is dat antwoord: minder dan vijf procent kans.
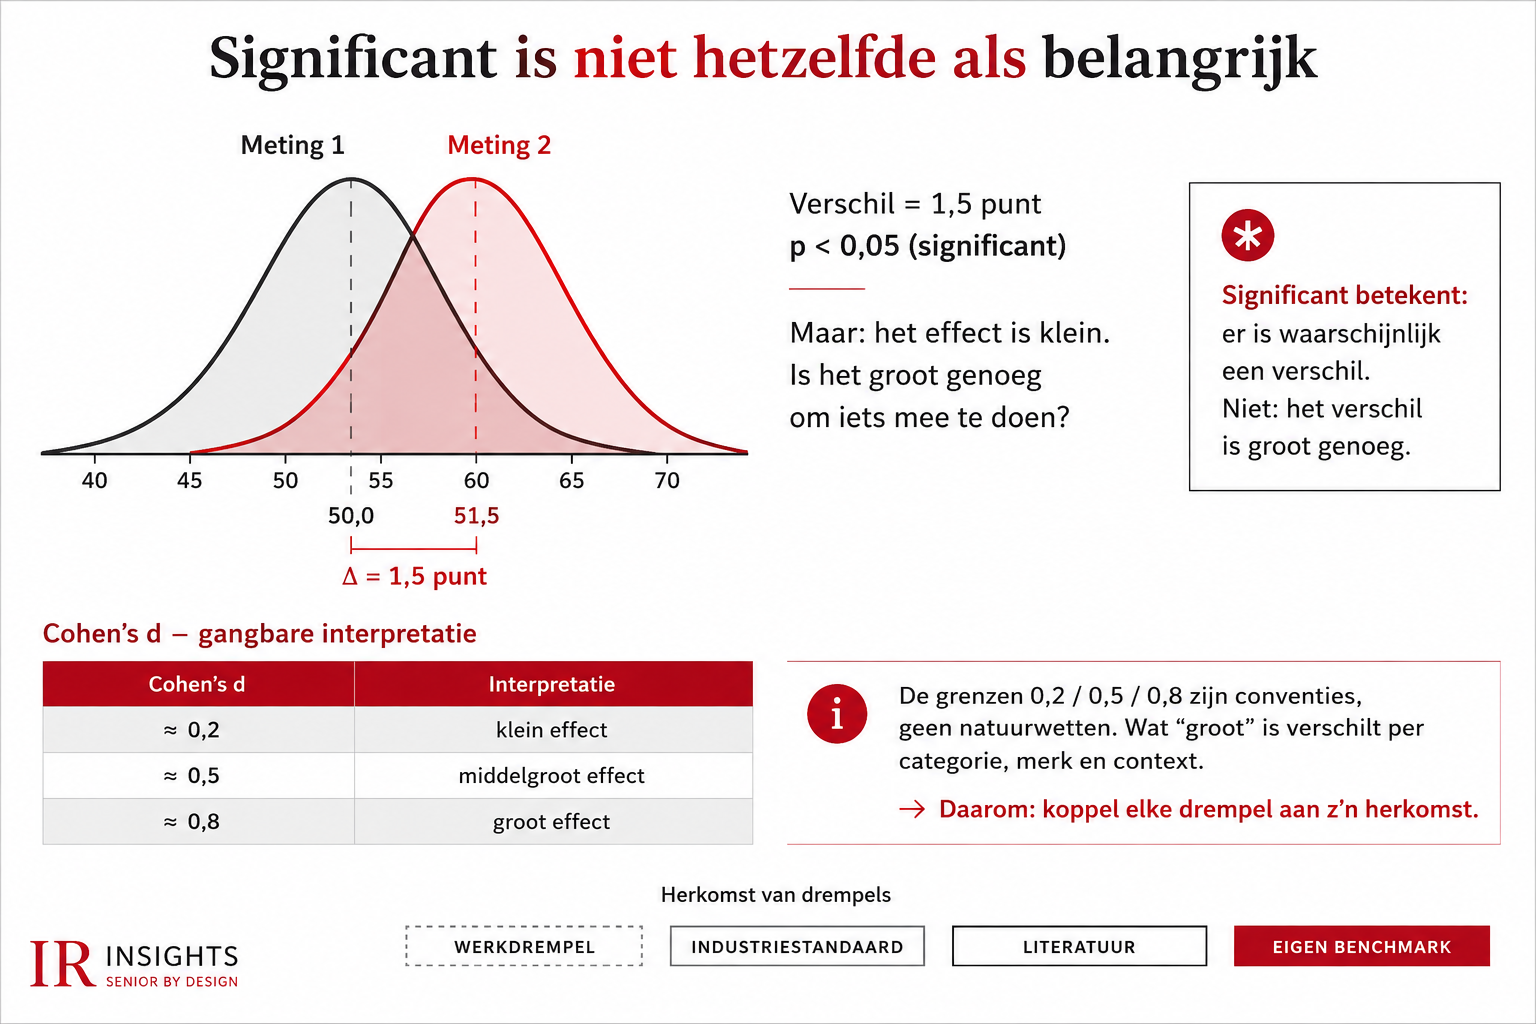
Dat is een uitspraak over **bestaan**, niet over **omvang**. Significantie zegt: er is waarschijnlijk iets. Ze zegt niets over de vraag of dat iets groot genoeg is om uw budget, uw positionering of uw prijs op aan te passen.
En hier zit de valkuil die in vrijwel elke trackerrapportage terugkomt: significantie hangt sterk af van uw steekproefomvang. Bij n=200 heeft u een flink verschil nodig voordat er een sterretje verschijnt. Bij n=4.000 wordt een verschuiving van 1,5 procentpunt al significant — en met vier golven per jaar bij een grote steekproef krijgt u een tabel vol sterretjes waar nagenoeg niets in beweegt.
Groeit uw steekproef, dan groeit uw aantal significante bevindingen. Uw merk is niet veranderd. Uw tabel wel.
De omgekeerde fout is even duur
Andersom komt ook voor, en die is riskanter. Bij een kleine steekproef of een subgroep — “gebruikers in de leeftijd 18-34”, n=87 kan een fors verschil van acht procentpunt níet significant zijn. De conclusie luidt dan dat er geen effect is.
Dat klopt niet. De juiste conclusie is: deze meting was niet gevoelig genoeg om dit effect vast te stellen. Afwezigheid van bewijs is geen bewijs van afwezigheid. Wie op basis van zo’n cel besluit dat een propositie niet aanslaat bij jongeren, gooit mogelijk iets weg dat wel werkt.
Significantie en Cohen’s d
Effectgrootte: de vraag die er wél toe doet
De aanvullende vraag is: hoe groot is het verschil eigenlijk, uitgedrukt in een maat die niet van de steekproefomvang afhangt?
Voor het vergelijken van twee gemiddelden is Cohen’s d de gangbare maat. Het is het verschil tussen de gemiddelden, gedeeld door de gepoolde standaarddeviatie. De conventionele interpretatie:
| Cohen’s d | > | Interpretatie |
| ≈ 0,2 | > | klein effect |
| ≈ 0,5 | > | middelgroot effect |
| ≈ 0,8 | > | groot effect |
Voor verschillen tussen percentages — de meeste trackermetrieken — werkt het simpeler: kijk naar het absolute verschil in procentpunten en naar het betrouwbaarheidsinterval eromheen. Een stijging in merkbekendheid van 31% naar 33% met een interval van ±2,8 procentpunt is misschien significant, maar het interval loopt van bijna nul tot bijna vijf. U weet dan nog steeds niet of er twee punten bij zijn gekomen of bijna niets.
Twee waarschuwingen bij die drempeltabel. De grenzen 0,2/0,5/0,8 zijn **conventies**, geen natuurwetten. Cohen zelf noemde ze een noodgreep bij gebrek aan beter, bedoeld voor situaties waarin geen domeinkennis beschikbaar is. En wat “groot” is verschilt per categorie: in een verzadigde FMCG-markt is een verschuiving van twee punten in penetratie fors, terwijl bij een nieuw merk in een groeiende categorie tien punten normaal kan zijn.
Dat is precies de reden waarom een drempel altijd zijn herkomst moet dragen.
Wat wij daarom rapporteren
In onze rapportages en in het BrandTracker Platform staat bij elk verschil niet alleen of het significant is, maar ook hoe groot het is en hoe zeker we daarover zijn. En bij elke drempel die we hanteren staat waar hij vandaan komt: `Literatuur`, `Industriestandaard`, `Werkdrempel` of `Eigen benchmark`.
Ook als het antwoord “werkaanname” is. Dan zeggen we dat, in plaats van er een wetenschappelijk ogende norm van te maken. Een drempel zonder herkomst is een mening met een cijfer eromheen.
Dat is bewerkelijker dan een sterretje zetten. Het levert wel iets op wat u aan uw directie kunt uitleggen — en wat standhoudt als iemand doorvraagt.
Drie vragen voor uw volgende rapportage
Krijgt u een tabel met significantietoetsen, stel dan deze drie vragen:
1. **Hoe groot is het verschil, in procentpunten of in effectgrootte?** Niet alleen: is het significant.
2. **Wat is het betrouwbaarheidsinterval?** Als dat interval de nul omvat of bijna omvat, weet u minder dan het sterretje suggereert.
3. **Hoeveel vergelijkingen zijn er getoetst?** Bij honderd toetsen op p < 0,05 zijn er zonder enig echt effect al zo’n vijf significant. Wordt daarvoor gecorrigeerd, of wordt de mooiste cel eruit gelicht?
Krijgt u op die drie vragen geen helder antwoord, dan heeft u geen bevinding. Dan heeft u een tabel.
Twijfelt u of de verschillen in uw eigen tracker groot genoeg zijn om iets mee te doen? Leg ze vrijblijvend voor. U spreekt meteen de onderzoeker die ernaar kijkt. Boek vrijblijvend een uur met een senior